Del video opaco al conocimiento auditable
Un video concentra transcript, imágenes, secuencias y afirmaciones cuyo origen se pierde con facilidad al resumirlo. Construí este pipeline para que otro agente pueda razonar sobre una colección sin reabrir cada video y sin separar una respuesta de la evidencia que la sostiene.
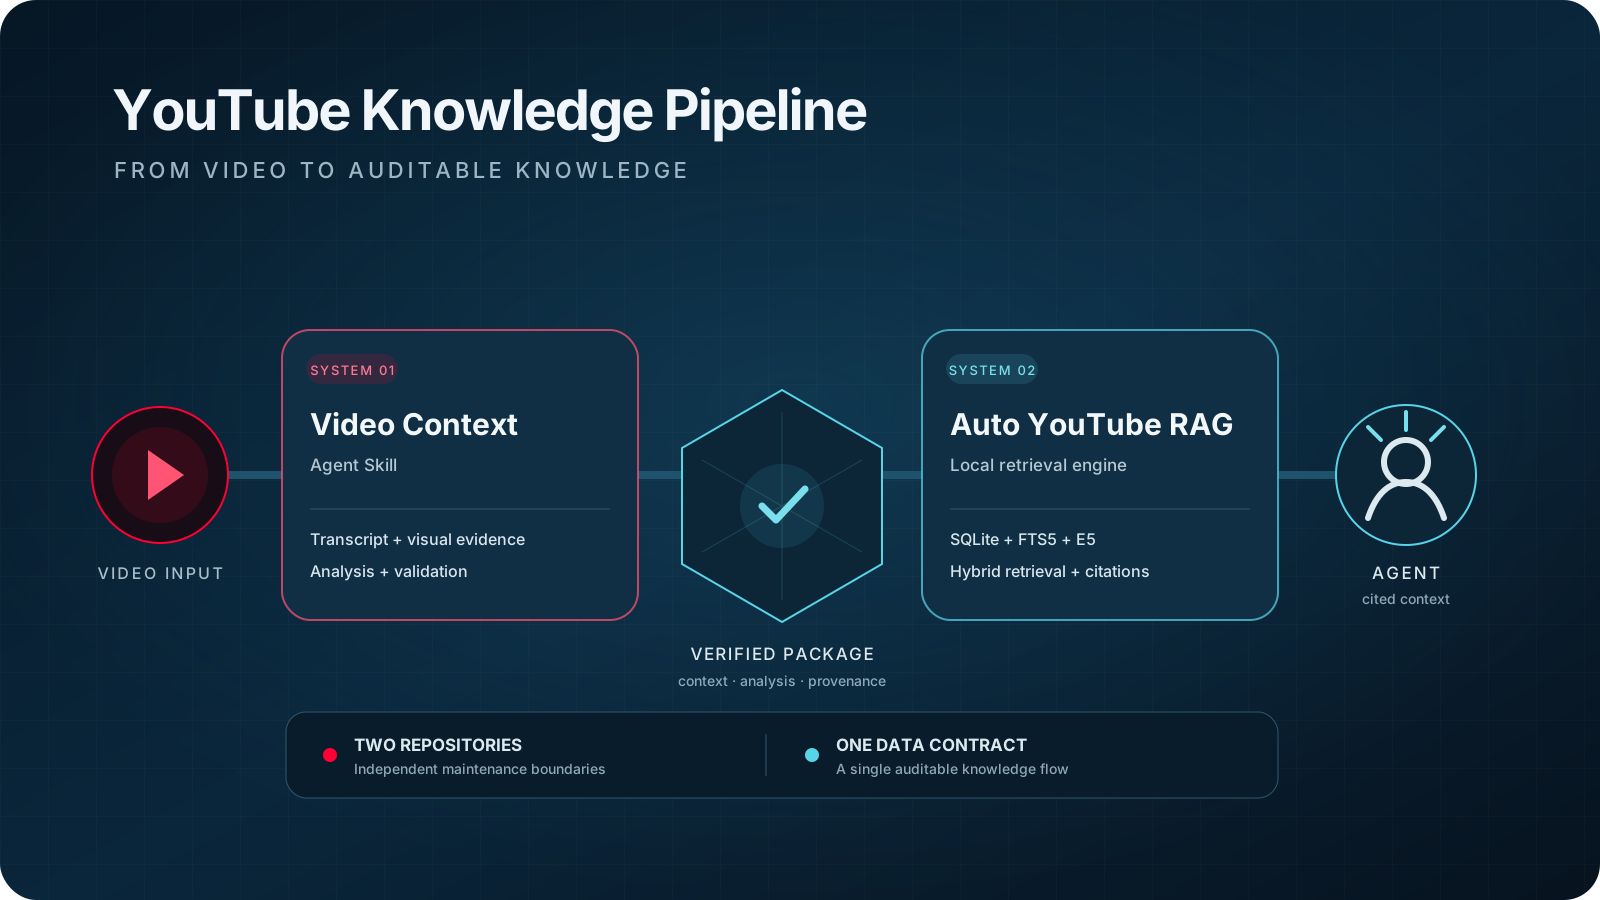
La experiencia se reparte entre dos repositorios públicos. youtube-video-context
es la Agent Skill que descarga el material, inspecciona la evidencia visual y produce un paquete validado.
auto-youtube-rag lee esos paquetes sin modificarlos,
los indexa y ensambla contexto citado para el agente que hará la interpretación final.
No alcanza con descargar subtítulos y resumir
La skill está definida contra capacidades —shell, lectura, escritura, búsqueda e inspección de imágenes— para que su procedimiento no dependa de un proveedor específico. Por cada video conserva la fuente, el transcript, la metadata y la cobertura visual; antes de redactar construye un ledger que relaciona cada afirmación con su evidencia, su clasificación y sus límites.
Cobertura base y adaptativa
Extrae exactamente 20 frames uniformes entre el 0 % y el 95 % y los complementa con cambios de escena, anclas temporales, secuencias densas y capturas suplementarias cuando el movimiento o una escena omitida cambian el significado.
Evidencia con clase propia
Mantiene separadas seis clases: fuente directa, confirmación visual, afirmación temporal, afirmación no verificada, juicio del analista y recomendación. El dossier no presenta todas las observaciones con el mismo grado de certeza.
Artefactos para personas y máquinas
Entrega context.md para lectura y analysis.json con schema 2.0 para consumo estructurado, junto con transcript, metadata, frames y un registro de cobertura visual.
Validación antes de publicar
El validador comprueba estructura, identidad, claves, profundidad, frames citados y cobertura declarada. La revisión semántica y el contrato de idiomas permanecen en una checklist manual explícita.
Esa última frontera es importante: validate-dossier.py es un validador del paquete, no una suite de
tests del código. Puede probar que los artefactos canónicos existen y son coherentes, pero no decidir si
el análisis entendió bien el video. La extracción automática y la revisión semántica quedan registradas
por separado en visual/coverage.json.
Dos repositorios, una frontera de datos explícita
La skill puede terminar su trabajo sin el RAG; el RAG, en cambio, fue diseñado como consumidor de ese
contenido. La frontera está expresada en archivos, no en una integración implícita: manifest.json
declara la colección y sus recursos; context.md conserva el dossier legible; analysis.json schema
2.0 aporta la representación estructurada que el parser valida antes de dejarla entrar a la aplicación.
La fuente queda inmóvil
sync solo lee los paquetes. La base, el modelo y los resultados viven en la biblioteca local del RAG, de modo que indexar o reconstruir no reescribe la evidencia producida por la skill.
El contrato puede evolucionar
El lector actual entiende analysis.json 2.0 y conserva compatibilidad con rules.json 1.0 para colecciones históricas. Ambos formatos son mutuamente excluyentes por paquete.
Esa decisión permite mantener Python y TypeScript en repositorios separados sin convertirlos en dos experiencias desconectadas dentro del portafolio.
Índice incremental, dominio aislado e infraestructura reemplazable
auto-youtube-rag adopta una arquitectura centrada
en dominio con puertos y adaptadores. El dominio conserva identidades, entidades y reglas sin conocer
SQLite, el modelo de embeddings ni la CLI; la aplicación define casos de uso y puertos; infraestructura
implementa filesystem, persistencia, embeddings y búsqueda; main compone las piezas concretas.
Sincronización incremental
Hashes por fuente vuelven la indexación incremental e idempotente. La jerarquía documento → sección → unidad y la procedencia se conservan sin tocar el paquete original.
Persistencia local
SQLite y FTS5 guardan catálogo, texto y estado del índice. La biblioteca puede reconstruirse desde las fuentes inmutables si cambia una decisión de infraestructura.
Embeddings en la máquina
E5 Small genera vectores locales y la búsqueda exacta en memoria cubre la ruta semántica elegida para el MVP. La red solo interviene al descargar el modelo durante la inicialización.
Recuperación, no generación
El sistema no contiene un LLM ni produce la respuesta final. Su responsabilidad termina al entregar context.md y result.json con evidencia y procedencia para otro agente.
Mantener esas fronteras hizo reemplazables los detalles de infraestructura y dejó el comportamiento central comprobable sin levantar una interfaz humana ni depender de un servicio remoto durante el uso.
Recuperar amplio sin soltar la procedencia
La consulta combina FTS5 y búsqueda vectorial, fusiona ambas rutas con weighted Reciprocal Rank Fusion,
expande ancestros, deduplica y diversifica antes de ensamblar el presupuesto de contexto. Los modos
focused, balanced y deep cambian cuánto material entra, pero no eliminan la referencia que conecta
cada fragmento con su fuente.
Integridad de citas: 24/24
El reporte del 2026-08-12 cubre 8 consultas en 3 profundidades. Los 24 bundles mantuvieron correspondencia entre sus citas [S0N] y result.json, mientras un digest SHA-256 verificó que la colección no cambiara durante sync y las consultas.
31,71 ms frente a 156,60 ms
Con el mismo fixture de 50.000 vectores, la búsqueda exacta en memoria registró p50 de 31,71 ms y sqlite-vec 156,60 ms, con conjuntos top-k 100 % coincidentes. Es una medición de una máquina documentada, no una promesa universal de velocidad.
La evidencia automatizada pertenece al RAG: hay 65 archivos *.test.ts, además de type-test, smoke y
E2E. La cobertura atraviesa dominio, aplicación con fakes, contratos compartidos de adaptadores, SQLite
real, CLI e integración; el pipeline de CI ejecuta los checks y el build. El número de archivos no prueba
calidad por sí solo, pero permite rastrear que las decisiones de recuperación, persistencia y ensamblado
están ejercitadas fuera del README.
La separación técnica sostiene una sola experiencia
Local-first, sin cerebro generativo
La skill preserva evidencia y el RAG la vuelve consultable en la máquina. No hay UI humana ni LLM interno: el agente consultante interpreta el contexto y redacta la respuesta.
Separados para mantener, unidos para usar
La skill es portable y puede usarse sola. El RAG depende de su contrato de paquetes. Los dos repositorios conservan ciclos técnicos propios, mientras el portafolio muestra una única unidad funcional.
El resultado no intenta esconder esa asimetría. Generar conocimiento verificable y recuperarlo son problemas distintos; el contrato explícito permite resolverlos por separado sin perder la experiencia que motivó el proyecto: razonar sobre una colección de videos sin reabrirlos y sin abandonar la procedencia.